De schrik van de cloudfactuur
De cloud beloofde flexibiliteit, maar levert vooral verrassingen Ik spreek wekelijks met mensen die gefrustreerd zijn over hun Azure-kosten en…
Waarom de echte besparing tegenwoordig op de tekentafel zit, en niet meer in het dashboard
Je hebt de eerste grote opruimronde in Azure achter de rug. De vergeten VM’s zijn verwijderd, de reserveringen zijn geregeld en testomgevingen gaan buiten kantooruren uit. Het dashboard ziet er een stuk beter uit. Toch blijft de factuur iedere maand oplopen.
Dat is ook niet zo vreemd. Terwijl je aan de ene kant probeert de bestaande omgeving goedkoper te maken, worden aan de andere kant nieuwe applicaties uitgerold, databases ingericht en clusters opgetuigd. En die beginnen lang niet altijd met de meest efficiënte configuratie.
Misschien moeten we ons daarom wat minder druk maken over de euro’s die we achteraf proberen terug te verdienen, en wat meer over de euro’s die we bij het ontwerpen al kunnen voorkomen.
De meeste organisaties die serieus met FinOps bezig zijn, hebben de eerste optimalisatieronde inmiddels achter de rug. Ongebruikte resources zijn opgeruimd, overcapaciteit is teruggebracht en voor voorspelbare workloads zijn reserveringen afgesloten.
Daarna wordt het lastiger. Natuurlijk valt er nog genoeg te optimaliseren, maar de grote, voor de hand liggende besparingen zijn meestal al gerealiseerd. Wat overblijft, vraagt meer uitzoekwerk en levert per afzonderlijke ingreep vaak minder op.
Ondertussen groeit de omgeving gewoon door.
In de State of FinOps 2026 komt naar voren dat organisaties steeds meer behoefte hebben aan inzicht in de kosten vóórdat nieuwe workloads worden uitgerold. Dat vind ik een interessante ontwikkeling. Kennelijk beginnen we te beseffen dat een groot deel van de toekomstige cloudrekening al wordt bepaald voordat de eerste resource is aangemaakt.
En toch besteden we nog altijd veel meer aandacht aan het optimaliseren van bestaande omgevingen dan aan het financieel onderbouwen van nieuwe ontwerpen.
Stel je voor dat je een huis laat bouwen. Tijdens het ontwerpen besluit je een muur een meter te verplaatsen. Een paar lijnen aanpassen op de tekening en klaar.
Probeer datzelfde eens als het huis al staat, de leidingen zijn aangelegd en de keuken is geplaatst. Dan wordt het ineens een behoorlijk dure ingreep.
Bij cloudarchitectuur werkt het niet heel anders.
Tijdens het ontwerp wordt gekozen voor een bepaalde Azure SQL-configuratie, geo-replicatie, premium storage of een AKS-cluster met voldoende capaciteit om eventuele toekomstige groei op te vangen. Allemaal keuzes waar meestal goede technische argumenten voor zijn.
Maar wat kosten die keuzes eigenlijk? En zijn ze allemaal noodzakelijk?
Die vragen worden lang niet altijd gesteld. Niet omdat architecten niet geïnteresseerd zijn in kosten, maar omdat beschikbaarheid, performance en security nu eenmaal bovenaan het lijstje staan. Bovendien is het lastig om de werkelijke kosten van een nog niet bestaande omgeving goed in te schatten.
Als de applicatie eenmaal draait, zijn die keuzes een stuk moeilijker terug te draaien. Je kunt nog wel wat capaciteit afschalen, maar een fundamenteel andere inrichting betekent al snel opnieuw testen, migreren en soms zelfs downtime.
Dat had je liever op de tekentafel opgelost.
Neem een nieuwe bedrijfsapplicatie waarvoor een Azure SQL-database nodig is. De architect kiest een ruime configuratie, inclusief extra voorzieningen voor beschikbaarheid. Begrijpelijk, want niemand wil verantwoordelijk zijn voor een database die na drie maanden al tegen zijn grenzen aanloopt.
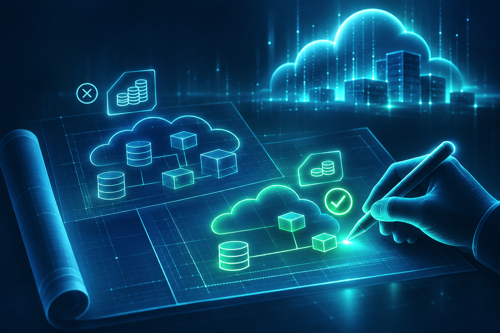
Maar stel dat je vooraf twee ontwerpen doorrekent.
Het eerste ontwerp kost naar verwachting € 8.000 per maand. Een tweede ontwerp, beter afgestemd op het verwachte gebruik, komt uit op € 5.500. Beide voldoen aan de gestelde eisen voor performance, beveiliging en beschikbaarheid.
Dat scheelt € 30.000 per jaar. Niet door achteraf iets uit te zetten, maar simpelweg door vooraf een andere keuze te maken.

Dit is een illustratief rekenvoorbeeld. De werkelijke kosten en mogelijke alternatieven hangen uiteraard af van de workload en de technische eisen.
Het interessante is dat niemand die € 30.000 ooit als besparing in een dashboard terugziet. De hogere kosten zijn immers nooit gemaakt.
En daar zit volgens mij een belangrijk probleem. We kunnen tegenwoordig behoorlijk goed laten zien hoeveel geld we besparen door bestaande resources te optimaliseren. Maar hoe maak je zichtbaar wat een architect heeft bespaard door iets meteen goed te ontwerpen?
Wat mij opvalt, is dat organisaties vaak veel meer informatie beschikbaar hebben dan ze tijdens het ontwerpen gebruiken.
We weten hoeveel een vergelijkbare database op dit moment kost. We kunnen zien hoeveel CPU en geheugen daadwerkelijk worden gebruikt, welke pieken optreden en hoeveel storage ongebruikt blijft. We weten vaak zelfs welke configuraties structureel te ruim zijn opgezet.
Maar die kennis komt meestal pas op tafel als iemand de cloudrekening gaat analyseren.
De architect die vandaag een nieuwe applicatie ontwerpt, werkt ondertussen met de Azure-prijscalculator, technische documentatie en aannames over het toekomstige gebruik. Op zich prima hulpmiddelen, maar ze vertellen niet automatisch wat een vergelijkbare workload binnen de eigen organisatie werkelijk kost.
Dat vind ik eigenlijk best merkwaardig. We verzamelen steeds meer informatie over onze cloudomgeving, maar gebruiken die vooral om achteraf te verklaren waarom iets duurder is geworden dan verwacht.
Terwijl diezelfde informatie juist bij een volgend ontwerp ontzettend waardevol kan zijn.
Binnen FinOps wordt vaak gesproken over kostenbesparing en het voorkomen van kosten. Dat lijkt misschien hetzelfde, maar er zit een belangrijk verschil tussen.
Als je een bestaande database optimaliseert en de maandkosten dalen van € 8.000 naar € 5.500, kun je dat vrij eenvoudig aantonen. De factuur is lager en het dashboard laat zien waar dat vandaan komt.
Maar als je bij een nieuwe applicatie meteen voor de configuratie van € 5.500 kiest, is er geen eerdere factuur om mee te vergelijken.
Toch heb je in beide gevallen dezelfde € 2.500 per maand minder nodig.
Daarom zou ik graag zien dat we bij architectuurkeuzes niet alleen vastleggen waarom een bepaalde technische oplossing is gekozen, maar ook welke alternatieven zijn overwogen en wat die ongeveer zouden kosten.
Dat hoeft echt geen uitgebreid financieel onderzoek te worden. Een eenvoudige kostenparagraaf in het ontwerp kan al voldoende zijn. Wat verwachten we maandelijks kwijt te zijn? Welke onderdelen bepalen het grootste deel van die kosten? En waarom kiezen we niet voor een goedkoper alternatief?
Daarbij moet je natuurlijk wel eerlijk vergelijken. Een database zonder geo-replicatie is niet automatisch een slimmer ontwerp dan eentje met geo-replicatie. Als de business die extra beschikbaarheid nodig heeft, is het gewoon een verstandige investering.
Het gaat erom dat die afweging bewust wordt gemaakt, en niet pas wanneer de eerste facturen binnenkomen.
Ik denk dat organisaties hier veel kunnen winnen zonder meteen nieuwe processen, commissies of ingewikkelde goedkeuringsprocedures in te voeren.
Begin gewoon eens met het bekijken van bestaande workloads voordat je een nieuwe ontwerpt.
Wat kost een vergelijkbare database bij ons? Hoeveel capaciteit gebruiken we daarvan daadwerkelijk? Welke keuzes zouden we achteraf anders hebben gemaakt?
Met die informatie kun je een nieuw ontwerp een stuk beter onderbouwen dan wanneer je uitsluitend uitgaat van de theoretische capaciteit en de prijzen uit een calculator.
En kijk vervolgens na de deployment of je aannames klopten. Misschien blijkt dat de applicatie veel minder capaciteit nodig heeft dan gedacht. Of juist meer. In beide gevallen leer je iets waar je bij de volgende architectuurkeuze wat aan hebt.
Dat klinkt allemaal niet bijzonder ingewikkeld. En dat hoeft het volgens mij ook niet te zijn.
We gebruiken CloudXcellence om inzicht te krijgen in de werkelijke kosten en het gebruik van bestaande Azure-resources en workloads. Natuurlijk om verspilling te vinden en bestaande omgevingen te optimaliseren, maar die informatie is minstens zo interessant wanneer er iets nieuws gebouwd gaat worden.
Onze consultants kunnen die praktijkinformatie meenemen in architectuurgesprekken. Niet om iedere technische keuze vanuit kosten te beoordelen, maar om inzichtelijk te maken wat verschillende opties financieel betekenen.
Een zwaardere database-tier kan prima de juiste keuze zijn. Net zoals geo-replicatie of extra capaciteit voor piekbelasting. Alleen wil je vooraf wel weten wat je daarvoor betaalt en of het ook echt nodig is.
Door na de uitrol de verwachte kosten met de werkelijkheid te vergelijken, bouw je bovendien steeds meer kennis op over wat bepaalde architectuurkeuzes binnen je eigen omgeving betekenen.
Daarmee wordt FinOps niet alleen iets van de mensen die de factuur analyseren, maar ook van de mensen die bepalen hoe die factuur er straks uit gaat zien.
Ik verwacht niet dat we ooit klaar zullen zijn met het optimaliseren van bestaande cloudomgevingen. Daarvoor verandert er te veel, zowel in het gebruik als in de technologie.
Maar als we alleen blijven kijken naar wat er vandaag draait, lopen we steeds achter de feiten aan.
De volgende grote besparing zit misschien helemaal niet in je huidige Azure-omgeving. Misschien zit die in een architectuurdiagram dat volgende week wordt besproken, in een database-tier die nog gekozen moet worden of in een cluster dat nog gebouwd gaat worden.
En juist daar kun je relatief eenvoudig een keuze maken die jarenlang verschil maakt.
Met een Azure Cost Scan van OptimaSure brengen we de kosten en het gebruik van je bestaande omgeving in kaart. Niet alleen om te zien waar je vandaag kunt besparen, maar ook om toekomstige keuzes beter te onderbouwen.
Want een euro die je niet onnodig uitgeeft, hoef je later ook niet terug te verdienen.